
 3 Tháng mười một, 2026
Skewness là gì và vì sao nó quan trọng khi phân tích dữ liệu? Trong bài viết này, Luận Văn 1080 sẽ giải thích cho bạn khái niệm về skewness, cách nhận biết lệch dương, lệch âm, công thức tính hệ số độ lệch và cách đọc kết quả qua những ví dụ quen thuộc. Cùng theo dõi nhé!
1. Skewness là gì trong thống kê?
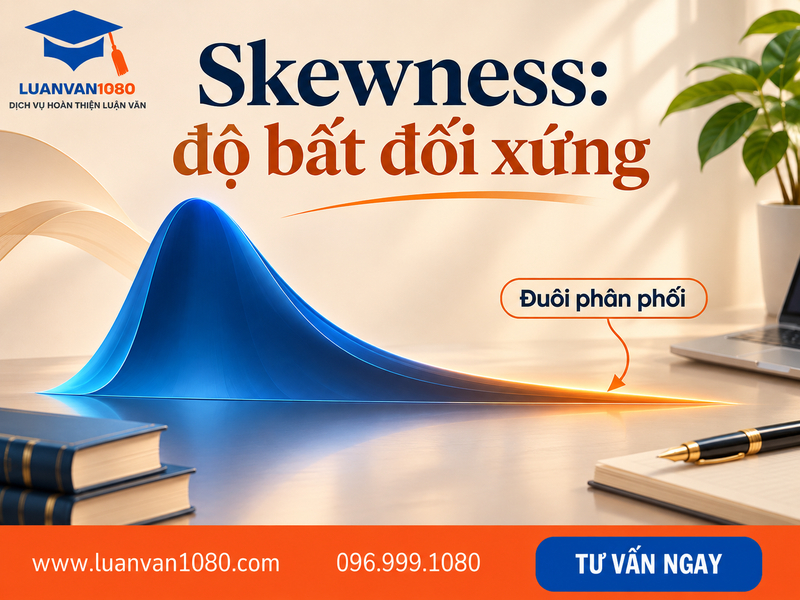
Vậy skewness là gì? Skewness (độ lệch, hay hệ số độ lệch) là chỉ số đo mức độ bất đối xứng của phân phối dữ liệu quanh giá trị trung bình. Nói đơn giản, skewness cho biết dữ liệu cân đối hai bên hay đang “nghiêng” về một phía. Theo NIST, skewness là thước đo tính đối xứng, hay chính xác hơn là sự thiếu đối xứng.
Mốc so sánh là phân phối chuẩn, tức đường cong hình chuông thường gặp ở chiều cao, cân nặng hay điểm IQ. Ở đây hai đuôi dài bằng nhau, trung bình = trung vị = yếu vị, và skewness bằng 0. Khi một đuôi dài hơn đuôi còn lại, phân phối bị lệch:
- Đối xứng: Hai đuôi cân bằng ≈ 0
- Lệch phải (dương): Đuôi phải dài hơn > 0
- Lệch trái (âm): Đuôi trái dài hơn < 0
Ví dụ: Thu nhập thường sẽ lệch bên phải. Đa số có mức thu nhập trung bình, một số ít thu nhập rất cao kéo đuôi về bên phải. Khi đó trung bình thường lớn hơn trung vị.
Skewness là gì trong thống kê?
Bài viết liên quan: Trung bình mẫu
2. Các loại skewness (độ lệch) thường gặp
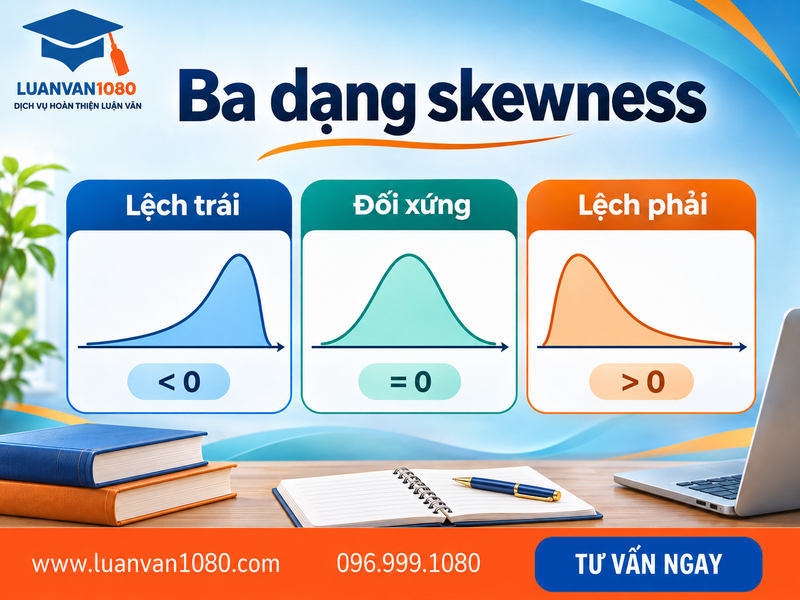
Sau khi hiểu skewness là gì, tiếp theo bạn cần phân biệt các dạng của nó. Dựa vào dấu của hệ số, skewness được chia thành ba loại: bằng không, dương và âm. Mỗi loại cho thấy một cách dữ liệu phân tán quanh giá trị trung bình.
Độ lệch bằng không (phân phối đối xứng)
Đây là trường hợp “lý tưởng”, điển hình là phân phối chuẩn:
- Dữ liệu tập trung đều quanh trung bình, hai nửa phân phối giống như ảnh phản chiếu của nhau.
- Hai đuôi dài bằng nhau, không nghiêng về phía nào.
- Trung bình = trung vị = yếu vị (mode), cùng nằm tại điểm trung tâm.
Với dữ liệu thực tế, ba giá trị này hiếm khi trùng khít hoàn toàn. Tuy vậy, chênh lệch thường rất nhỏ, đủ để xem phân phối là gần đối xứng.
Độ lệch dương (lệch phải)
- Đuôi phải dài hơn trái.
- Phần lớn giá trị thấp dồn về “đỉnh đồi”, các giá trị cực lớn rải dài ở đuôi phải.
- Thứ tự thường gặp là mode < trung vị < trung bình. Phân phối lệch dương có đuôi kéo về bên phải và thường có trung bình lớn hơn trung vị.
Ví dụ: thu nhập cá nhân, giá nhà, thời gian chờ phục vụ.
Độ lệch âm (lệch trái)
- Đuôi trái dài hơn phải.
- Phần lớn giá trị cao dồn về “đỉnh đồi”, các giá trị cực nhỏ rải dài ở đuôi trái.
- Thứ tự thường gặp là trung bình < trung vị < mode.
Ví dụ: điểm của một bài kiểm tra dễ, tuổi thọ khi qua đời ở các quốc gia phát triển.
Các loại skewness (độ lệch) thường gặp
3. Công thức tính hệ số skewness
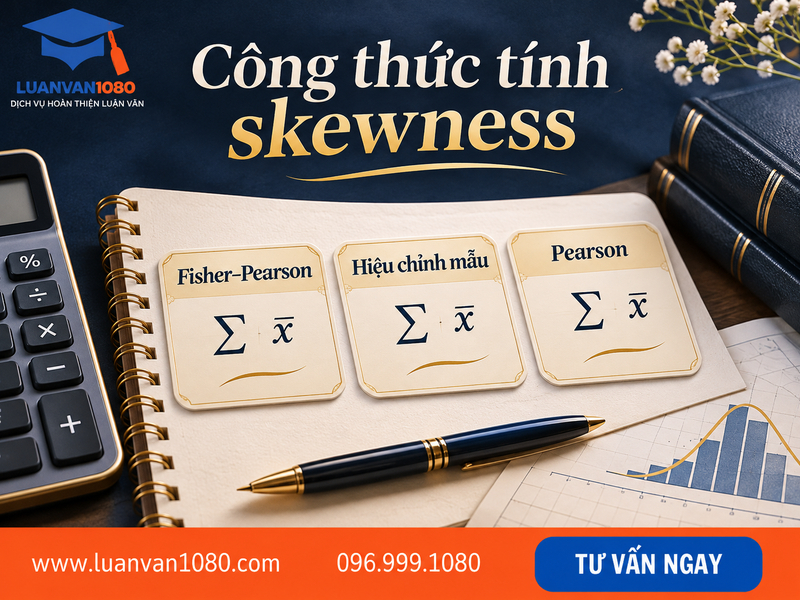
Khi đã nắm được skewness là gì và các dạng lệch, bạn có thể lượng hóa mức độ lệch bằng con số cụ thể. Có ba nhóm công thức tính skewness phổ biến:
Hệ số mô-men Fisher–Pearson (g₁)
Đây là công thức gốc, dựa trên mô-men trung tâm bậc 3:
g₁ = [ (1/n) × Σ(xᵢ − x̄)³ ] / [ (1/n) × Σ(xᵢ − x̄)² ]^(3/2)
Trong đó:
- xᵢ: từng giá trị quan sát
- x̄: giá trị trung bình
- n: số quan sát
Tử số dùng lũy thừa bậc 3 nên giữ nguyên dấu của độ lệch. Các giá trị cực lớn bên phải kéo tổng lên dương, các giá trị cực nhỏ bên trái kéo tổng xuống âm. Mẫu số chuẩn hóa kết quả theo độ phân tán, nên skewness là đại lượng không có đơn vị và so sánh được giữa các bộ dữ liệu. Công thức này còn được gọi là hệ số mô-men skewness của Pearson. Trong Excel, công thức này tương ứng với hàm SKEW.P.
Hệ số hiệu chỉnh cho mẫu (G₁)
Khi chỉ có một mẫu, g₁ thường ước lượng thấp độ lệch thật. Vì vậy, các phần mềm thường dùng phiên bản đã điều chỉnh:
G₁ = g₁ × √[n(n − 1)] / (n − 2)
Đây là công thức của hàm SKEW trong Excel và cũng được dùng trong SPSS. Hàm này cần ít nhất 3 giá trị: nếu có ít hơn ba điểm dữ liệu hoặc độ lệch chuẩn mẫu bằng 0, SKEW trả về lỗi #DIV/0! Khi n lớn, G₁ và g₁ gần như bằng nhau.
Hệ số Pearson: tính nhanh từ các giá trị trung tâm
Nếu cần ước lượng nhanh mà không cần tính mô-men, bạn có thể dùng hai hệ số của Pearson:
- Hệ số thứ nhất (dựa trên mode): Sk₁ = (x̄ − Mode) / s
- Hệ số thứ hai (dựa trên trung vị): Sk₂ = 3 × (x̄ − Trung vị) / s
Với s là độ lệch chuẩn. Hệ số thứ hai được dùng nhiều hơn vì mode thường không ổn định hoặc không xác định rõ.
Công thức tính hệ số skewness
Bài viết liên quan: Cỡ mẫu
4. Cách tính skewness bằng Excel, SPSS, Python
Sau khi đã hiểu skewness là gì và công thức tính skewness, sau đây Luận Văn 1080 sẽ hướng dẫn bạn tính skewness trên Excel, SPSS và Python.
4.1. Tính skewness trong Excel
Excel có hai hàm tính skewness:
- =SKEW(range): Dữ liệu là mẫu
- =SKEW.P(range): Dữ liệu là tổng thể
Ví dụ: Dữ liệu 3, 4, 5, 2, 3, 4, 5, 6, 4, 7 nằm ở ô A2:A11.
- =SKEW(A2:A11) → 0,3595
- =SKEW.P(A2:A11) → 0,3032
=> Kết quả dương nghĩa là phân phối có đuôi bất đối xứng kéo dài về phía các giá trị dương hơn, tức dữ liệu lệch phải.
Nếu muốn xem skewness cùng các thống kê khác, bạn có thể bật Analysis ToolPak, rồi vào Data → Data Analysis → Descriptive Statistics và tick Summary statistics.
Lưu ý: Nếu có ít hơn ba điểm dữ liệu hoặc độ lệch chuẩn mẫu bằng 0, SKEW trả về lỗi #DIV/0!
4.2. Tính skewness trong SPSS
SPSS tính skewness theo công thức hiệu chỉnh G₁, giống hàm SKEW của Excel.
Cách 1: Dùng giao diện
- Vào Analyze → Descriptive Statistics → Descriptives.
- Chuyển biến cần phân tích sang ô Variable(s).
- Nhấn Options, tick Skewness (có thể tick thêm Kurtosis), rồi chọn Continue → OK.
Ngoài ra, bạn cũng có thể dùng Frequencies hoặc Explore để xem skewness kèm histogram.
Cách 2: Dùng cú pháp
DESCRIPTIVES VARIABLES=income
/STATISTICS=MEAN STDDEV SKEWNESS KURTOSIS.
Đọc kết quả: Bảng Output có cột Statistic (giá trị skewness) và Std. Error (sai số chuẩn). Theo tài liệu của IBM, tùy chọn SKEWNESS sẽ trả về skewness và sai số chuẩn của skewness. Nếu tỉ số skewness / Std. Error nằm trong khoảng ±2, dữ liệu có thể xem là không lệch đáng kể.
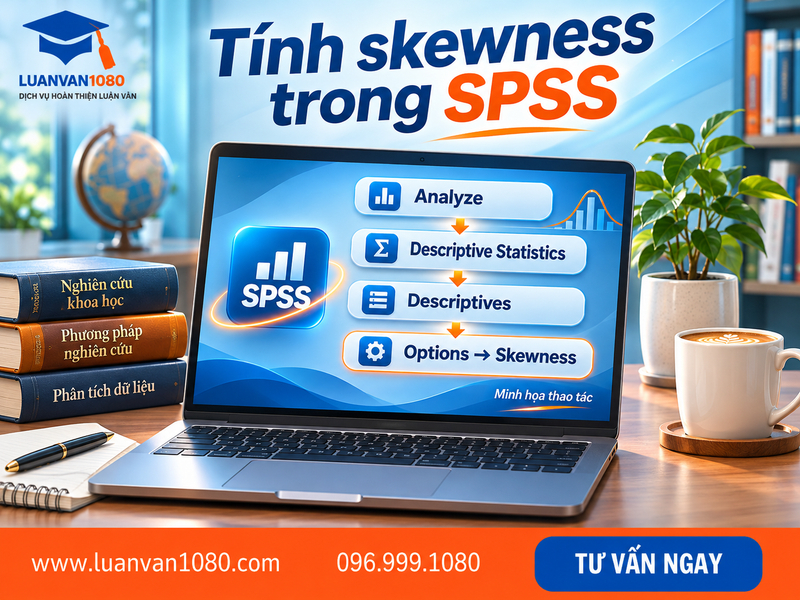
Tính skewness trong SPSS
4.3. Tính skewness trong Python
Ví dụ dưới đây dùng cột price trong bộ dữ liệu diamonds của Seaborn.
Cách 1: Tính thủ công theo hệ số Pearson thứ hai
import numpy as np
import seaborn as sns
prices = sns.load_dataset(“diamonds”)[“price”]
pearson_skew = 3 * (prices.mean() – prices.median()) / prices.std()
print(f”Pearson’s second skewness: {pearson_skew:.5f}”)
# Pearson’s second skewness: 1.15189
Cách 2: Tính thủ công theo hệ số mô-men đã hiệu chỉnh (G₁)
def moment_based_skew(x):
n = len(x)
z = (x – np.mean(x)) / np.std(x, ddof=1) # chuẩn hóa bằng độ lệch chuẩn mẫu
return n / ((n – 1) * (n – 2)) * np.sum(z ** 3)
moment_based_skew(prices) # ≈ 1.6184
Cách 3: Dùng hàm dựng sẵn
# pandas: trả về G₁ (đã hiệu chỉnh)
prices.skew() # 1.618395…
# SciPy: mặc định trả về g₁ (Fisher–Pearson)
from scipy.stats import skew
skew(prices) # 1.618350…
skew(prices, bias=False) # bằng kết quả của pandas
Theo tài liệu SciPy, khi bias=False, phép tính được hiệu chỉnh độ chệch và giá trị trả về là hệ số mô-men chuẩn hóa Fisher–Pearson đã hiệu chỉnh.
Cả bốn kết quả đều lớn hơn 1, nghĩa là giá kim cương lệch phải mạnh: phần lớn viên có giá vừa phải, chỉ một số ít có giá rất cao kéo dài đuôi phải. Hệ số Pearson (1,15) thấp hơn các hệ số mô-men (≈1,62) nhưng vẫn cho cùng kết luận.
5. Skewness và kurtosis khác nhau như thế nào?
Khi tìm hiểu skewness là gì, bạn sẽ thường gặp thêm khái niệm kurtosis (độ nhọn). Hai chỉ số này hay xuất hiện cùng nhau trong bảng thống kê mô tả, nhưng mỗi chỉ số trả lời một câu hỏi khác nhau về hình dạng phân phối:
| Tiêu chí | Skewness | Kurtosis |
| Đo lường | Mức bất đối xứng | Độ nặng của đuôi |
| Câu hỏi trả lời | Dữ liệu lệch trái hay phải? | Dữ liệu có nhiều giá trị cực trị không? |
| Mô-men sử dụng | Bậc 3 | Bậc 4 |
| Giá trị ở phân phối chuẩn | 0 | 3 (excess = 0) |
| Có thể âm? | Có, âm khi lệch trái | Excess kurtosis có thể âm |
| Hàm trong Excel | SKEW | KURT (trả về excess kurtosis) |
Theo NIST, nhiều kiểm định và khoảng tin cậy cổ điển dựa trên giả định phân phối chuẩn, và skewness cùng kurtosis đáng kể là dấu hiệu rõ ràng cho thấy dữ liệu không chuẩn. Vì vậy, khi kiểm tra dữ liệu trước khi phân tích, hãy đọc cả hai chỉ số cùng với histogram hoặc biểu đồ Q-Q.
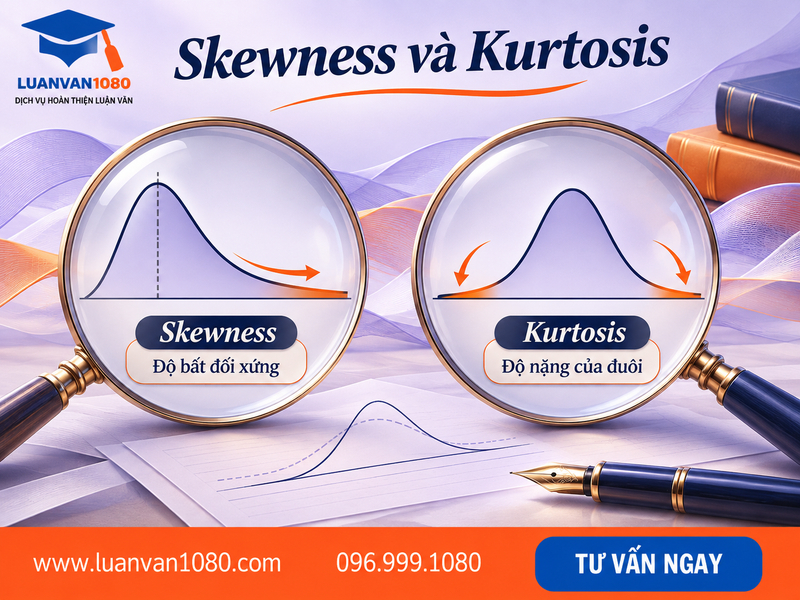
Skewness và kurtosis khác nhau như thế nào?
Bài viết liên quan: Tần số tích lũy
6. Ý nghĩa của skewness khi phân tích dữ liệu nghiên cứu, khóa luận
Trong nghiên cứu và khóa luận, hiểu skewness là gì giúp bạn chọn đúng phương pháp phân tích ngay từ đầu. Nếu bỏ qua bước kiểm tra skewness, bạn rất dễ dùng sai kiểm định và đưa ra kết luận thiếu chính xác.
Kiểm tra giả định phân phối chuẩn
Nhiều phương pháp phổ biến như t-test, ANOVA, tương quan Pearson và hồi quy tuyến tính giả định dữ liệu có phân phối chuẩn. Một cách kiểm tra nhanh là tính z-score của skewness, tức skewness chia cho sai số chuẩn của nó. Theo Kim (2013), ngưỡng đánh giá phụ thuộc vào cỡ mẫu:
- Mẫu nhỏ (n < 50): dữ liệu không chuẩn nếu |z| > 1,96.
- Mẫu vừa (50–300): dữ liệu không chuẩn nếu |z| > 3,29.
- Mẫu lớn (n > 300): bỏ qua z-score, xem histogram và giá trị skewness tuyệt đối. Nếu |skewness| > 2 thì dữ liệu lệch đáng kể.
Cần phân biệt theo cỡ mẫu vì sai số chuẩn giảm khi cỡ mẫu tăng, nên với mẫu lớn, giả thuyết phân phối chuẩn dễ bị bác bỏ dù dữ liệu không khác biệt đáng kể.
Chọn kiểm định tham số hay phi tham số
Khi dữ liệu tuân theo phân phối chuẩn, dùng kiểm định tham số; ngược lại, dùng phương pháp phi tham số. Ví dụ, nếu dữ liệu lệch mạnh, bạn có thể thay:
- Independent t-test bằng Mann-Whitney U
- Paired t-test bằng Wilcoxon
- ANOVA bằng Kruskal-Wallis
- Tương quan Pearson bằng Spearman
Báo cáo đúng chỉ số trung tâm
Với dữ liệu lệch, trung bình bị giá trị cực trị kéo lệch nên không còn đại diện tốt. Vì vậy:
- Dữ liệu gần chuẩn: báo cáo Mean ± SD.
- Dữ liệu lệch mạnh: báo cáo trung vị và khoảng tứ phân vị (IQR).
Xử lý khi dữ liệu bị lệch
Khi phát hiện dữ liệu lệch, bạn có thể làm theo thứ tự sau:
- Kiểm tra giá trị ngoại lai và lỗi nhập liệu.
- Biến đổi dữ liệu bằng log, căn bậc hai hoặc Box-Cox.
- Chuyển sang kiểm định phi tham số.
Đừng kết luận chỉ dựa vào một con số. Nên kết hợp quan sát trực quan, skewness, kurtosis và các kiểm định chuẩn chính thức như Shapiro-Wilk.
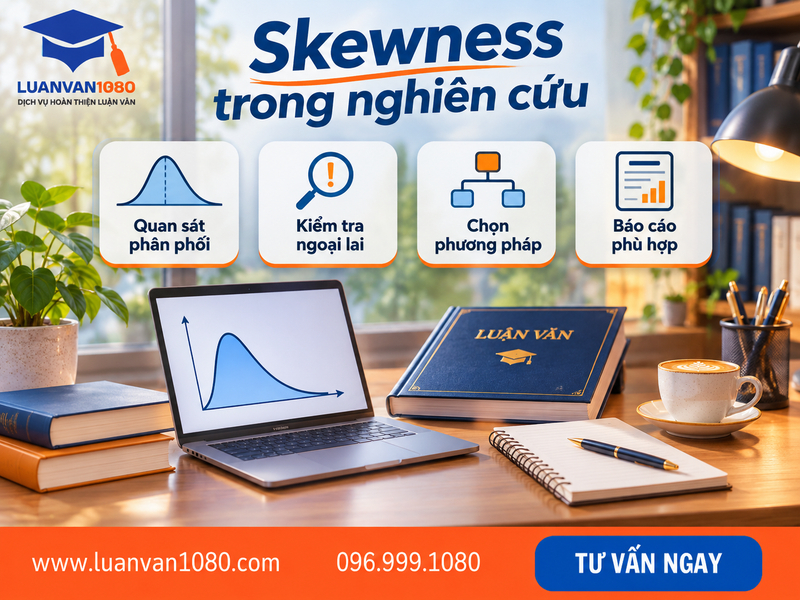
Ý nghĩa của skewness khi phân tích dữ liệu nghiên cứu, khóa luận
Hy vọng bài viết trên đã giúp bạn trả lời rõ câu hỏi Skewness là gì và hiểu cách dùng hệ số độ lệch trong thống kê: từ khái niệm, các dạng lệch dương, lệch âm, công thức tính, đến cách thực hiện trên Excel, SPSS, Python và ứng dụng trong nghiên cứu. Nếu bạn gặp khó khăn khi xử lý dữ liệu, chạy SPSS hay hoàn thiện khóa luận, dịch vụ viết thuê luận văn tại Luận Văn 1080 luôn sẵn sàng đồng hành, hỗ trợ bạn từ A đến Z.
Nguồn tài liệu:
- Measures of Skewness and Kurtosis – NIST/SEMATECH e-Handbook: https://www.itl.nist.gov/div898/handbook/eda/section3/eda35b.htm
- Skewness – Wikipedia: https://en.wikipedia.org/wiki/Skewness
- SKEW function – Microsoft Support: https://support.microsoft.com/en-us/office/skew-function-bdf49d86-b1ef-4804-a046-28eaea69c9fa
- SKEW.P function – Microsoft Support: https://support.microsoft.com/en-au/office/skew-p-function-76530a5c-99b9-48a1-8392-26632d542fcb
- Kim, H. Y. (2013). Restorative Dentistry & Endodontics, 38(1), 52–54: https://pmc.ncbi.nlm.nih.gov/articles/PMC3591587/
 Share